목차
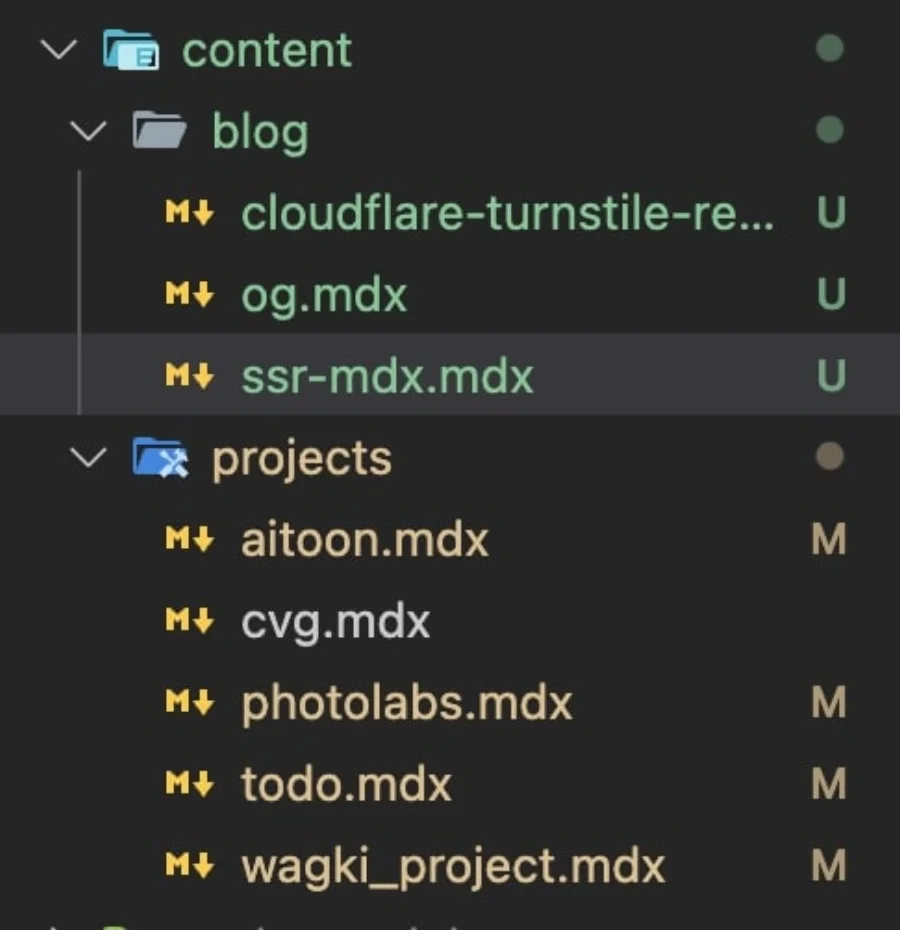
이 블로그의 글은 content/blog 폴더의 MDX 파일로 관리합니다. 빌드할 때 Content Collections가 frontmatter를 검사하고 MDX를 변환합니다. App Router는 그 결과로 목록과 상세 페이지를 만들고, 제목과 설명은 검색 결과와 링크 미리보기에도 다시 씁니다.
예전에는 이 블로그를 SSR 기반이라고 소개했습니다. 그런데 Server Component와 [slug]를 쓴다는 이유만으로 SSR이 되는 건 아니었습니다. 로컬 MDX를 빌드할 때 읽고 generateStaticParams로 경로를 열거한다면 중심은 정적 생성입니다. 서버 코드는 빌드 중에도 실행될 수 있습니다.
MDX에서 페이지까지
이 프로젝트의 콘텐츠 흐름은 짧습니다.
Content Collections 설정에는 파일 위치, frontmatter 스키마, MDX 변환 함수를 둡니다. 날짜나 공개 여부를 여기서 검사하면 페이지 컴포넌트마다 방어 코드를 되풀이하지 않아도 됩니다.
빌드가 끝난 컬렉션은 content-collections라는 가상 import 경로처럼 사용합니다. 실제 설정에서는 이 이름이 .content-collections/generated를 가리키므로 애플리케이션 코드는 생성 디렉터리의 내부 파일을 알 필요가 없습니다.
이 import에는 이미 스키마 검사를 거친 데이터와 컴파일된 MDX가 들어 있습니다. 상세 페이지가 요청될 때마다 파일 시스템에서 원문을 읽고 gray-matter를 실행하는 구조가 아닙니다. 개발 중에는 파일 변경을 감지해 다시 만들지만 배포본의 컬렉션은 빌드 산출물에 포함됩니다.
동적 경로의 정적 생성
[slug]는 URL 모양이 동적이라는 뜻입니다. 렌더링 시점까지 자동으로 정하지는 않습니다. 알려진 글 경로를 generateStaticParams에서 반환하면 Next.js는 빌드할 페이지를 미리 알 수 있습니다.
현재 App Router의 params는 Promise로 다루는 형태가 기본입니다. 페이지와 generateMetadata, 코드로 만드는 opengraph-image.tsx 모두 await params 패턴을 맞추면 오래된 동기식 예제와 섞이지 않습니다.
정적으로 만든 페이지도 완성된 HTML을 전달하므로 검색 엔진이 본문을 읽을 수 있습니다. SEO 때문에 반드시 SSR을 택해야 한다는 설명은 맞지 않습니다. 요청마다 달라지는 권한, 쿠키, 최신 원격 데이터가 없다면 로컬 글은 정적 생성 쪽이 단순하고 캐시하기도 쉽습니다.
본문과 메타데이터의 공통 원본
페이지 제목, 설명, 표지가 서로 다른 조회 경로를 가지면 수정할 때 하나가 빠집니다. 상세 페이지와 generateMetadata가 같은 blog.getPage([slug])를 사용하면 frontmatter가 화면과 <head>의 공통 원본이 됩니다.
상대 URL을 쓴다면 상위 layout의 metadataBase가 절대 URL로 해석할 기준을 제공해야 합니다. 공유 크롤러가 로그인이나 자바스크립트 실행 없이 접근할 수 있는 이미지여야 한다는 조건도 남습니다.
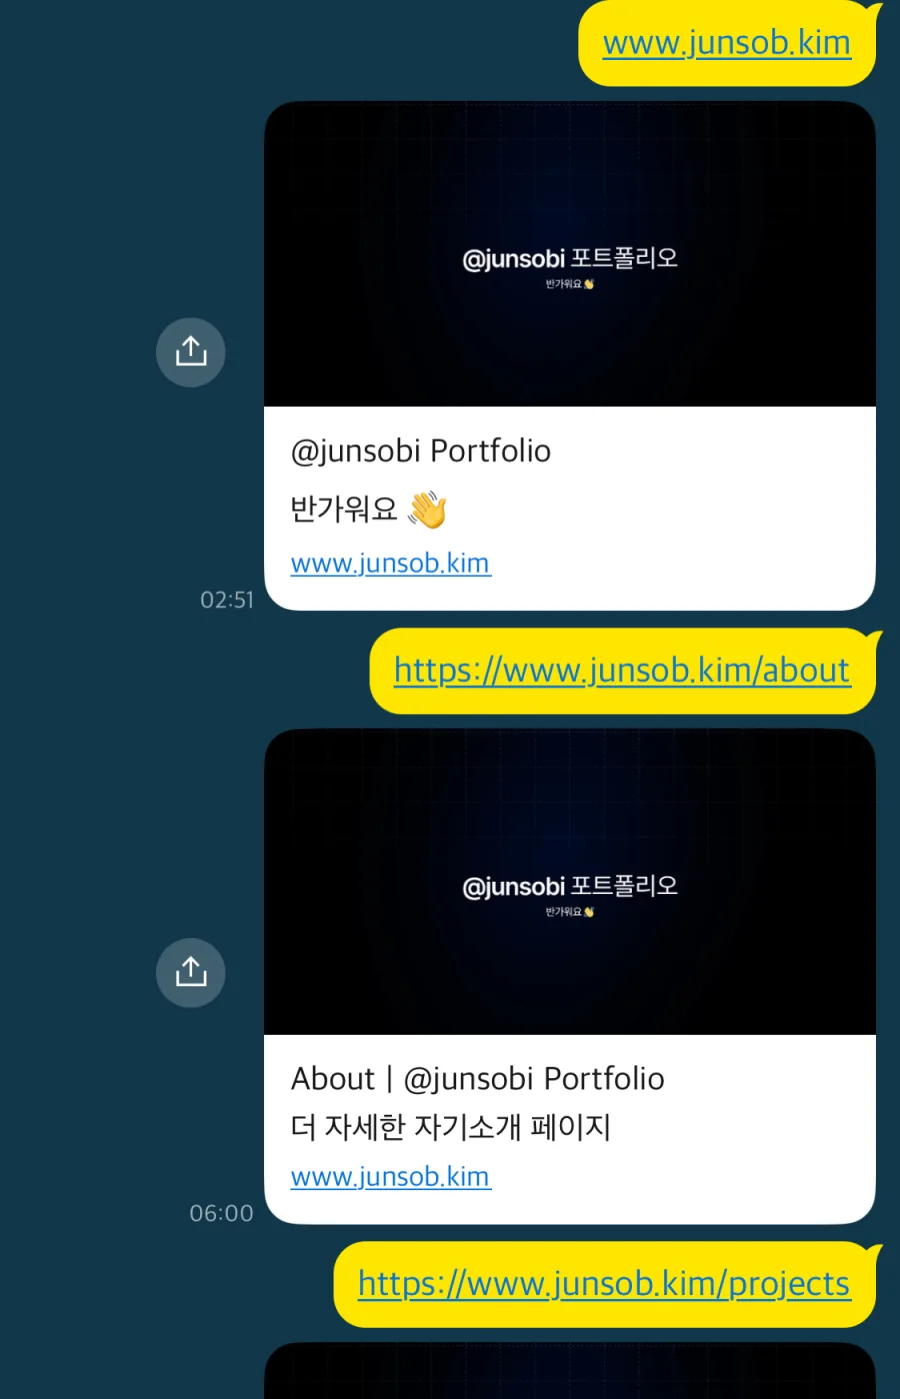
Open Graph와 X 카드 메타데이터는 역할이 비슷해도 같은 필드 집합은 아닙니다. 카카오톡을 비롯한 여러 공유 서비스는 주로 og:title, og:description, og:image를 읽습니다. X에는 twitter:card와 twitter:image 같은 별도 태그가 있습니다. 한쪽 값이 다른 쪽을 완전히 대체한다고 기대하기보다 Next.js Metadata 객체에 둘을 명시해 같은 콘텐츠를 가리키게 합니다. 실제 미리보기는 각 서비스의 캐시와 크롤링 정책에 따라 갱신 시점이 달라질 수 있습니다.
표지 파일과 opengraph-image.tsx
이 포트폴리오는 글마다 /images/blog/<slug>/cover.webp 경로를 만들고 상세 페이지 상단과 소셜 메타데이터에서 같은 파일을 사용합니다. 페이지 템플릿이 표지를 일관된 위치에 보여 주므로 본문 MDX에는 다시 넣지 않습니다.
표지 파일을 배포 전에 준비하기 어렵다면 app/blog/[slug]/opengraph-image.tsx와 ImageResponse로 해당 세그먼트의 Open Graph 이미지를 생성할 수 있습니다.
파일 규칙으로 만든 메타데이터는 같은 세그먼트의 메타데이터 설정보다 우선합니다. 정적 cover.webp를 generateMetadata에서 지정하는 방식과 opengraph-image.tsx 중 하나를 표지의 단일 원본으로 정해야 합니다. 파일 규칙은 /og?title=... API보다 글 라우트와 함께 찾기 쉽고 제목을 쿼리 문자열로 다시 전달할 필요도 없습니다.
Next.js는 요청 시 API나 캐시하지 않은 데이터를 쓰지 않는 생성 이미지를 기본적으로 정적 최적화하고 캐시합니다. 반대로 쿠키, 헤더, 캐시하지 않은 fetch가 끼면 요청 시점 작업이 될 수 있습니다. 폰트나 로고 같은 로컬 자산을 읽는다면 런타임과 배포 환경에서도 같은 경로를 찾을 수 있는지 확인합니다.
캐시와 배포의 대가
빌드 타임 MDX는 읽기 경로가 가볍습니다. 정적 HTML과 이미지를 CDN에 오래 둘 수 있고 런타임에 Markdown 파서나 콘텐츠 데이터베이스가 필요하지 않습니다. 스키마 오류도 사용자 요청이 아니라 빌드에서 발견합니다.
대신 글 한 줄을 고쳐도 새 컬렉션과 페이지를 만들고 배포해야 합니다. 배포 없이 CMS에서 즉시 발행하거나 요청마다 최신 데이터를 보여주는 구조에는 맞지 않습니다. 글 수와 MDX 변환 비용이 커지면 빌드 시간도 함께 늘어납니다. 이때는 모든 페이지를 요청 시 SSR로 돌리기보다 증분 빌드, 원격 콘텐츠 캐시, 일부 경로의 재검증 같은 선택지를 콘텐츠 갱신 요구에 맞춰 비교해야 합니다.
재검증도 원본이 배포 산출물 안에 있다는 점을 바꾸지는 않습니다. 서버가 오래된 content-collections 생성물을 들고 있다면 캐시만 비워도 새 MDX가 생기지 않습니다. 저장소의 글을 원본으로 삼는 이 구조에서는 콘텐츠 변경과 배포가 한 묶음입니다.
지금 이 블로그는 Content Collections가 빌드할 때 MDX를 타입이 있는 데이터로 만들고, App Router가 그 데이터로 정적 페이지와 소셜 메타데이터를 생성합니다. Server Component를 쓴다고 곧 SSR은 아닙니다. SSR은 콘텐츠가 요청마다 달라져야 할 때 따로 선택할 전략입니다.